標本比率とは?母比率との違いや公式・信頼区間の計算を徹底解説
内閣支持率の世論調査や新商品の購買意向調査、WebサイトのA/Bテストなどで目にする「支持率〇%」「クリック率〇%」といった数値。これらのベースとなっているのが統計学の基本概念である標本比率です。しかし、実務や学習の現場では「母比率とどう違うのか」「なぜ一部のデータから全体を推測できるのか」という疑問を抱く人が少なくありません。
データに基づいた意思決定が標準化した2026年のビジネス現場において、標本比率のメカニズムを正確に理解することは必須リテラシーとなっています。本記事では、標本比率の定義や公式、母比率との本質的な違いから、標準誤差、信頼区間の計算手順、実務におけるサンプルサイズの決定基準まで、専門用語の背景を解きほぐしながら徹底解説します。
📌 【この記事の重要ポイントまとめ】
- 要点1:標本比率は「抽出した一部のデータにおける特定の割合」であり、調査対象全体の真の割合である「母比率」を推測するために用いる。
- 要点2:標本比率のばらつきは「標準誤差」で数値化され、中心極限定理と正規分布近似を活用することで95%信頼区間などを導出できる。
- 要点3:サンプルの量だけでなく「無作為抽出(ランダム性)」が担保されていなければ、いくら標本比率を計算してもバイアスにより誤った判断を招く。
【基礎から整理】標本比率とは何か?母比率との違いと基本公式の使い分け
統計学において「比率」を扱う際、最初につまずきやすいのが標本比率と母比率の混同です。この2つは、視線が向けられている「対象の範囲」が根本的に異なります。
母比率(記号:$p$ または $P$)とは、調査対象となる集団全体(母集団)において、ある特定の性質を持つ要素の割合を指します。たとえば「日本全国の有権者全員における特定政党の支持率」や「工場で製造された全製品における不良品率」がこれに該当します。母集団の全数を調査(全数調査・センサス)できれば母比率は確定しますが、膨大なコストと時間がかかるため、現実には真の母比率を知ることは困難です。
そこで活用されるのが標本比率(記号:$\hat{p}$「ピー・ハット」や $p'$)です。母集団から無作為に抽出された一部の集団(標本・サンプル)において、特定の性質を持つ要素の割合を計算した数値を指します。
標本比率を求めるための標本比率の公式は極めてシンプルです。
【標本比率の計算式】
標本比率 $\hat{p} = \frac{x}{n}$
($n$:抽出したサンプルサイズ / 標本数、$x$:その中で該当したデータの個数)
たとえば、無作為に選んだ有権者1,000人($n = 1000$)のうち、450人($x = 450$)がある政策に「賛成」と答えた場合、標本比率は $\frac{450}{1000} = 0.45$(45%)となります。
ここで重要なのは、標本平均との違いです。標本平均は「年収」や「身長」「テストの点数」といった連続的な量的データを足し合わせて割った平均値です。一方、標本比率は「賛成か反対か」「購入したか否か」「合格か不合格か」という0か1かの二値データ(質的データ)を対象としています。ただし、統計学の数学的処理において、比率は「0と1の数値データの平均値」と見なすことができるため、標本平均の理論をそのまま応用できるという強力な特徴を持っています。
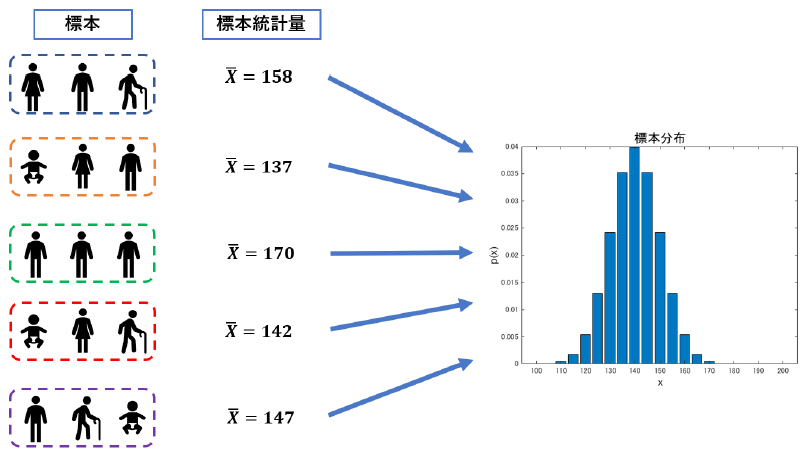
【計算手順を図解】標本比率の標準誤差と信頼区間の計算方法
標本調査を行う際、抽出するサンプルによって標本比率の値は毎回微妙に変動します。この「サンプリングによるブレ(ばらつき)」の大きさを表す指標が標本比率の標準誤差(Standard Error, SE)です。
コイン投げのように、結果が2通りしかない試行を独立して繰り返す事象の確率分布を二項分布と呼びます。標本サイズ $n$ が十分に大きい場合、中心極限定理の働きによって、二項分布は滑らかな山型の正規分布に近似(正規分布近似)できることが数学的に証明されています。
標本比率 $\hat{p}$ の標準誤差 $SE$ は、以下の公式によって算出されます。
【標本比率の標準誤差の公式】
$SE = \sqrt{\frac{p(1-p)}{n}} \approx \sqrt{\frac{\hat{p}(1-\hat{p})}{n}}$
母比率 $p$ が未知である実際の推計現場では、手元にある標本比率 $\hat{p}$ を代入して標準誤差を見積もります。
この標準誤差を用いることで、未知の母比率がどの範囲に含まれるかを確率的に推し量る母比率の推定が可能になります。推定には、1つの数値でズバリ予測する「点推定」と、確率的な幅を持たせて予測する「区間推定」の2種類が存在します。
ビジネスや学術研究で最も頻繁に使われる95%信頼区間の計算は、正規分布において平均から両側に「約1.96 × 標準誤差」の範囲にデータ全体の95%が含まれるという性質を利用します。
【母比率の95%信頼区間の計算式】
$\hat{p} - 1.96 \times \sqrt{\frac{\hat{p}(1-\hat{p})}{n}} \leqq p \leqq \hat{p} + 1.96 \times \sqrt{\frac{\hat{p}(1-\hat{p})}{n}}$
具体例として、あるWebサイトの訪問者1,600人のうち400人が会員登録をしたケース(標本比率 $\hat{p} = \frac{400}{1600} = 0.25$)を計算してみます。
- 標準誤差の計算:$\sqrt{\frac{0.25 \times (1 - 0.25)}{1600}} = \sqrt{\frac{0.1875}{1600}} = \sqrt{0.0001171875} \approx 0.0108$(約1.08%)
- 許容誤差(マージンオブエラー)の計算:$1.96 \times 0.0108 \approx 0.0212$(約2.12%)
- 95%信頼区間の導出:$0.25 - 0.0212 \leqq p \leqq 0.25 + 0.0212 \rightarrow 0.2288 \leqq p \leqq 0.2712$(22.88% 〜 27.12%)
これにより、「真の全ユーザー登録率(母比率)は、95%の確率で22.88%から27.12%の範囲内に存在する」と結論付けることができます。
【データ徹底比較】標本比率と主要な統計概念・推計手法の違い一覧
実務や統計検定の対策において、比率と平均、推定と検定の概念を整理しておくことは不可欠です。主要な統計指標と推計手法の相違点を下表にまとめました。
| 項目・概念 | 対象データ・計算対象 | 代表的な計算式・基準 | 実務における主な用途・役割 |
|---|---|---|---|
| 標本比率($\hat{p}$) | 抽出サンプルの二値・質的データ(Yes/No) | $\hat{p} = \frac{x}{n}$ | 調査速報値、母比率を推定するための点推定値 |
| 母比率($p$) | 母集団全体の真の比率(固定値だが通常未知) | $p = \frac{X}{N}$(全数調査時のみ算出) | 真の市場シェア、国勢調査結果、工場全体の真の不良率 |
| 標本平均($\bar{x}$) | 抽出サンプルの連続的・量的データ(数値) | $\bar{x} = \frac{1}{n}\sum x_i$ | 顧客単価、平均残業時間、製品寸法の平均値測定 |
| 点推定 vs 区間推定 | 未知の母数を推測するアプローチ | 点推定:$\hat{p}$ そのもの 区間推定:$\hat{p} \pm 1.96 \times SE$ | 単一値での簡易把握か、誤差リスクを織り込んだ意志決定か |
| 母比率の検定 | 「母比率がある特定値と異なるか」の仮説検証 | $Z = \frac{\hat{p} - p_0}{\sqrt{\frac{p_0(1-p_0)}{n}}}$ | 新施策によるCVR改善の有無判定、製品不良率の有意差判定 |
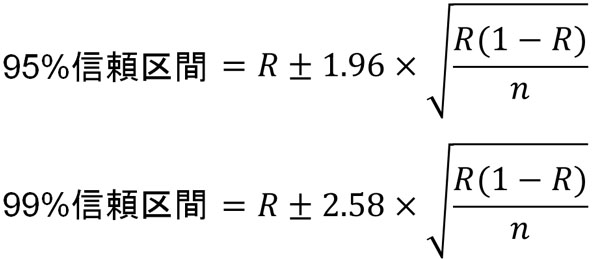
【実態検証】内閣支持率・マーケティング調査の現場で起きるブレとサンプルサイズの決定基準
報道各社が実施する世論調査を見ると、サンプルサイズが「1,000人〜2,000人」程度に設定されているケースが大半です。「数千万人の有権者がいるのに、わずか1,000人の標本比率で全体がわかるのか」という疑問はSNSや知恵袋などでも頻繁に提起されます。
この疑問を解く鍵が、サンプルサイズの決め方にあります。標本調査における誤差の限界(許容誤差 $E$)と信頼水準95%(係数1.96)の関係式は次の通りです。
【必要サンプルサイズの算出式】
$n = \frac{1.96^2 \times p(1-p)}{E^2}$
最も誤差が大きくなるのは比率が五分五分($p = 0.5$)のときであり、$p(1-p) = 0.25$ となります。ここで許容誤差 $E$ を $\pm 3\%$(0.03)に抑えたい場合、必要なサンプル数は次のように計算されます。
$n = \frac{1.96^2 \times 0.25}{0.03^2} \approx \frac{3.8416 \times 0.25}{0.0009} \approx 1067$(人)
つまり、母集団が1億人であっても、無作為抽出さえできていれば約1,067人集めるだけで、誤差を $\pm 3\%$ 以内に抑えて母比率を推計できる計算になります。サンプル数を1万人へ10倍に増やしても、誤差は $\pm 3\%$ から $\pm 0.98\%$ へと約3分の1程度にしか減少しません。費用対効果(コストパフォーマンス)の観点から、報道機関や調査会社は1,000〜2,000人を標準的なサンプルサイズとして採用しているのが現場の実際です。
一般に知られていない盲点とネットの誤解
標本比率を扱う上で、実務家や学習者が陥りやすい重大な落とし穴が2つあります。
1. 「サンプル数が多ければ正確」という誤解とサンプリングバイアス
インターネット上のアンケートやSNSの投票機能では、数万〜数十万件の回答が集まることがあります。「1,000人の世論調査より、10万人のSNS投票のほうが標本比率として正確だ」と主張する投稿も見受けられますが、これは統計学的に致命的な誤解です。
標本調査の理論は大前提として無作為抽出(ランダムサンプリング)を要求します。特定のインフルエンサーのフォロワーや、関心の高い層だけが自発的に回答するオンライン投票には強烈な「選択バイアス(サンプリングバイアス)」が存在します。偏った母集団からいくら大量の標本を集めても、得られる標本比率は真の母比率から大きく乖離した無意味な数値となります。
2. 正規分布近似の破綻条件(レアケースの落とし穴)
標本比率の信頼区間計算で用いられる正規分布近似は、どんな状況でも使えるわけではありません。統計学的な目安として、以下の条件を満たす必要があります。
【正規分布近似が適用できる条件】
$n \times \hat{p} \geqq 5$ かつ $n \times (1 - \hat{p}) \geqq 5$(より厳密には10以上)
たとえば、不良品率が0.1%($\hat{p} = 0.001$)という極めて稀な現象を調べる場合、サンプル数が1,000個($n = 1000$)あっても $n \times \hat{p} = 1$ となり、条件を満たしません。このような歪んだ分布に対して無理に通常の正規分布近似(Wald法)を適用すると、信頼区間の下限がマイナスの値になってしまうなどの不整合が生じます。比率が極端に小さい場合は、ポアソン分布を利用するか、ウィルソンの信頼区間(Wilson score interval)などの修正手法を採用しなければなりません。

【プロの結論】データドリブン意思決定で標本比率を正しく扱うための判断基準
標本比率は、限られた情報から全体像を素早く把握し、事業判断を下すための強力なコンパスです。しかし、使いどころを見誤ると間違った確信を生むリスクをはらんでいます。
標本比率による意思決定が適している場面
- A/Bテストや施策効果の比較:新旧デザインのコンバージョン率(CVR)の差を統計的に検証する際、母比率の検定を用いることで偶然のブレを排除できる。
- ロット単位の品質管理:数万個の部品から数百個を抜き取り検査し、不良品率の標本比率から出荷可否を判定する。
- スピーディな市場受容性調査:ターゲット層からランダム抽出した小規模モニター調査で、新サービスの受容比率を区間推定する。
標本比率の扱いに慎重になるべき場面
- 回答者の属性が偏る自発的アンケート:「満足した人のみ回答する」「クレーム層のみ書き込む」ようなオープンアンケートの比率をそのまま全体意向と判断する行為。
- 極小サンプルでの割合議論:サンプル数が10件しかない状態で「成功率80%」とアピールするなど、標準誤差が極大化している状態での点推定値の過信。
標本比率を見る際は、「その点推定値はいくつか」だけでなく、「サンプルサイズは何件か」「無作為性は保たれているか」「95%信頼区間の幅はどれくらいか」の3点をセットで確認する習慣を身につけることが、データに騙されないための鉄則です。
【標本比率とは】に関するよくある質問(FAQ)
Q1:なぜ母比率が分かっていないのに、標準誤差の計算ができるのですか?
A1:厳密な理論上、標準誤差の算出には母比率 $p$ が必要です。しかし実務では母比率は未知であるため、「標本比率 $\hat{p}$ は母比率 $p$ の最も優れた推定量(一致推定量・不偏推定量)である」という統計的性質に基づき、母比率の代わりに標本比率 $\hat{p}$ を代入して標準誤差を推計します。サンプルサイズが十分に大きければ、この代用による実用上の誤差は極めて小さくなります。
Q2:サンプルサイズは何件あれば標本比率から正規分布近似を使ってよいですか?
A2:一般的な基準としては、「サンプル数 $n \times$ 比率 $\hat{p} \geqq 10$」かつ「$n \times (1 - \hat{p}) \geqq 10$」の双方が成立していることが推奨されます。たとえば比率が50%(0.5)前後であれば $n=30 \sim 40$ 程度でも近似が機能しますが、比率が5%(0.05)のような偏ったデータでは最低でも $n=200$ 以上のサンプルサイズが必要になります。
Q3:点推定値だけで議論せず、わざわざ信頼区間(区間推定)を計算するメリットは何ですか?
A3:点推定値(「支持率40%」など)だけでは、その数値がどれほどのサンプリングのブレを内包しているかが分かりません。信頼区間を計算することで「真の支持率は95%の確率で37%〜43%の間にある」といったブレの範囲が可視化され、最悪のシナリオや不確実性を織り込んだリスク管理と意思決定が可能になるためです。
まとめ:不確実なデータを読み解く武器としての標本比率
標本比率は、全体を調べることが不可能な広大な母集団から、一部の標本を手がかりにして真実をあぶり出すための統計的アプローチです。
単に割合を計算するだけでなく、標準誤差を把握し、信頼区間を導き出すことで、手元のデータが持つ精緻さと不確実性の両面を冷静に評価できるようになります。マーケティング、製品開発、世論調査の解釈など、あらゆる局面で標本比率の正しいリテラシーを活用し、客観的でブレのないデータ分析を実践してください。 (出典: 標本 比率 と は(Yahoo!ニュース))
最新のトレンドや話題のニュースをわかりやすく解説するWebライターです。読者の皆様に役立つ情報を日々お届けしています。
